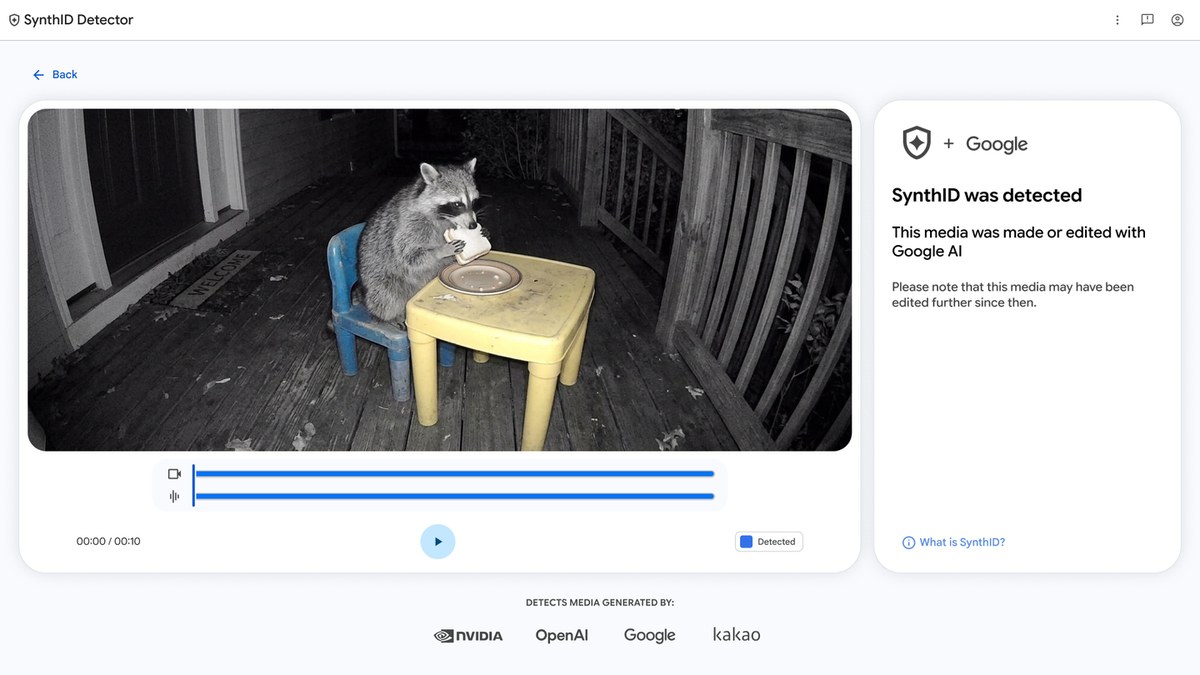
Клиент присылает «кадр с открытия» и просит поставить его в кейс. Раньше вопрос «это точно кадр, а не картинка из генератора» решался на глаз и на доверие. Теперь у этого вопроса есть кнопка: файл загружается на synthid.com, и через несколько секунд на экране либо «SynthID обнаружен», либо «не обнаружен».
Инструмент открыли для всех: раньше ранняя версия SynthID Detector была только для медиапрофессионалов, теперь доступна глобально и на английском. Принимает картинки (JPG, PNG, WEBP, HEIC, TIFF и другие), видео (MP4, MOV, WEBM) и аудио (WAV, MP3, OGG, FLAC, AAC, M4A). Загруженные файлы обрабатываются и сразу удаляются — Google хранит только цифровую подпись файла на сутки, чтобы ловить перебор.
Что обещают
С 2023 года Google помечает сгенерированное контентом невидимым водяным знаком, вшитым в сами пиксели и в частоты звука, а не в метаданные, которые теряются при пересылке. По их данным, помечено больше 180 миллиардов изображений и видео и 240 тысяч лет аудио. Детектор ловит метки не только Google, но и партнёров — OpenAI, NVIDIA, Kakao, а Apple «на подходе». Встроенные проверки в Поиске, приложении Gemini и Chrome, по словам Google, обрабатывают больше миллиона запросов в день.
Чего в анонсе не сказали
Главное написано на самом сайте детектора, только мелким шрифтом: «Это не общий детектор ИИ». Он видит ровно один сигнал — метку SynthID. Всё, что сгенерировано моделью без такой метки, для него неотличимо от снимка с телефона.
Отсюда вторая ловушка: «не обнаружено» не значит «снято человеком». Google сам предупреждает, что это не исключает ни генерацию, ни монтаж: метки может не быть у модели, её могли стереть сильными правками или сжатием. Бывает и обратное — в редких случаях метка срабатывает на контенте, который никто не генерировал.
И третье, самое неприятное для бизнеса: метка не неубиваемая. На GitHub лежит открытая библиотека, которая снимает водяные знаки и метаданные сразу нескольких систем (SynthID, C2PA, EXIF) — почти шесть тысяч звёзд, обновлена на этой неделе. То есть «чистый» файл может быть просто отмытым, и по отсутствию метки нельзя судить о происхождении.
Что с этим делать
Держать в голове, что это один сигнал, а не приговор. Проверять чужие материалы перед публикацией — да; обвинять клиента или конкурента на основании «не обнаружено» — нет. В переписке лучше писать «проверка метки ничего не нашла», а не «это подделка».
Ещё нюанс из условий сервиса: автоматические и массовые проверки запрещены — скриптом или через обход интерфейса не прогонишь, сервис рассчитан на ручные проверки. Если файлов много, это отдельная ручная операция, и её надо кому-то поручить.
Метка отвечает на вопрос «сделано ли это инструментом, который ставит метку», а не «правда ли то, что на файле». Путать эти два вопроса дорого: первый — техника, второй — репутация.