POST /api/alpha/decisions — и в ответе is_bug 0.97 · team frontend 0.88 · urgency 2.0. Парсить нечего: значения идут прямо в if. В прошлый раз я разбирал, зачем Jev нужен; теперь — как вызвать и где он спотыкается.
Три вопроса — это весь API
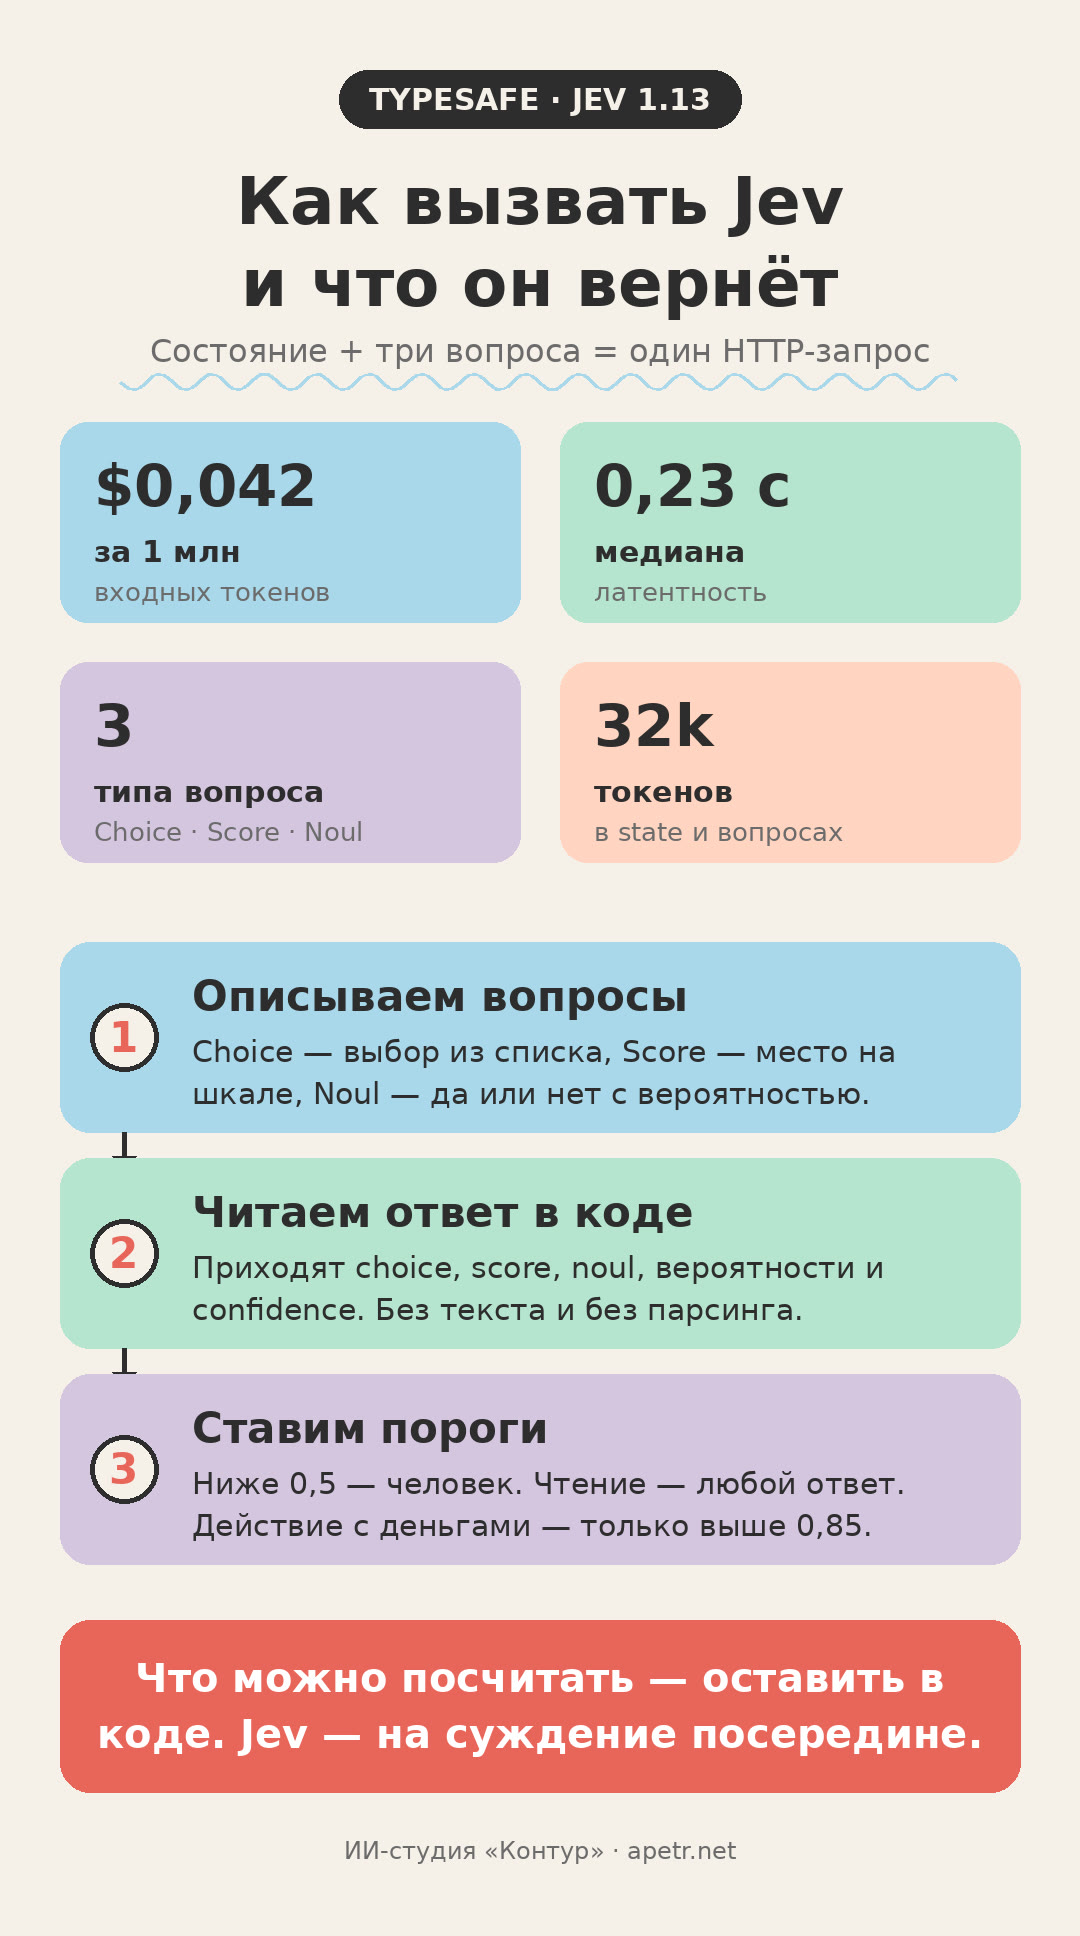
Jev — не чат. На вход текст (в документации «state») и типизированные вопросы, на выход — ответы на все сразу. Вопросов три вида: Choice — выбрать вариант из списка (до 255 штук), Score — место на шкале из 2–10 уровней (вернёт и 1.035, между уровнями), Noul — вероятность «да» от 0 до 1; отдельного confidence у него нет, сама цифра и есть уверенность.
Соберём маршрутизацию обращений в поддержку: ключ от OpenRouter, модель typesafe/jev-1.13. В state — тариф клиента и текст обращения; в вопросах — is_bug (Noul: «дефект, а не запрос фичи»), team (Choice: payments / frontend / account), urgency (Score: ждёт релиза / на этой неделе / блокирует выручку).
Что вернулось
На «страница оплаты белая, пробовал два браузера» пришло: баг 0.97, команда frontend 0.88, срочность 2.0. Один запрос, всё вместе. $0,042 за миллион входных токенов, выход бесплатный, стоимость ответа в usage.cost, медиана отклика 0,23 секунды.
Приём, который я забрал сразу: вопросы считаются параллельно, десятый вопрос времени почти не добавляет. В кухонной книге TypeSafe 13 вопросов по одному документу дали 12,2 раза дешевле и 10 раз быстрее, чем по очереди. То есть спрашивать надо всё сразу, включая то, что понадобится через один if: значимость решает код, а не порядок вызовов.
Порог — под цену ошибки
Рядом с ответом Choice и Score идут вероятности и confidence: модель обучали на калибровке уверенности. Поэтому порог пишется под каждое действие: ниже 0,5 — человек, чтение баланса — при любом ответе, возврат денег — только выше 0,85. А плоское распределение вероятностей почти всегда значит, что в критериях нет разницы между вариантами, а не что модель запуталась.
Где облажается
- Читает буквально: если «да» в правилах значит «нет», ответы просядут.
- Не считает и не сравнивает даты: пересчёт — цикл по одному Noul на элемент, дата — Choice по месяцам.
- Чужой текст в state может продавить классификацию: тестируйте отдельно.
- Контекст-рот настоящий: сначала отбираем и чистим в коде, в state — только нужные поля.
- Картинки и звук не понимает (сначала OCR или расшифровка), причины решений не объясняет — формулировку для человека пусть напишет чат-модель.
Зачем это вам
Граница простая: что можно посчитать — остаётся в коде, Jev — на узкое суждение посередине. Он не заменяет Opus или GPT, а решает, какой запрос заслуживает дорогой модели: статус заказа отдаёт код, жалобу — профильная чат-модель, неуверенность — человек. Приоритеты меняются коэффициентом в коде, а не промптом.
Лимиты: 32k токенов на state с самым длинным вопросом, 64k суммарно. Не «модель без болтовни», а датчик с известной погрешностью — его и ставят в if.