0,042 доллара за миллион входных токенов. Выход бесплатный. Ответ — за 70–500 миллисекунд против трёх секунд — пяти минут у больших моделей. Всё это про модель, у которой нет генерации текста: на вход она принимает состояние, на выход отдаёт типизированное решение с вероятностью.
Jev — первый публичный «System One Model» от TypeSafe AI: класс моделей, которые не ведут диалог, а заменяют собой ветку в коде — классифицировать, промаршрутизировать, оценить, извлечь, выбрать один из готовых вариантов. Автор — Diogo Almeida, основатель TypeSafe: в OpenAI он работал над методами, которые научили модели следовать инструкциям, — то исследование потом стало основой ChatGPT.
Что именно они поменяли
Три изменения. Первое — обучение: вместо RLHF (правятся ответы, приятные оценщику) и RLVR (проверяется то, что можно проверить программно) — RLCD, обучение с подкреплением для калиброванных решений: цель — честные вероятности. Второе — сэмплирование: параллельно, весь ответ за один запрос, а не по токену. Третье, главное, — формат вывода: структура задаётся заранее, поэтому типовая ошибка невозможна; разработчики называют это математически неизбежным свойством, а не обещанием.
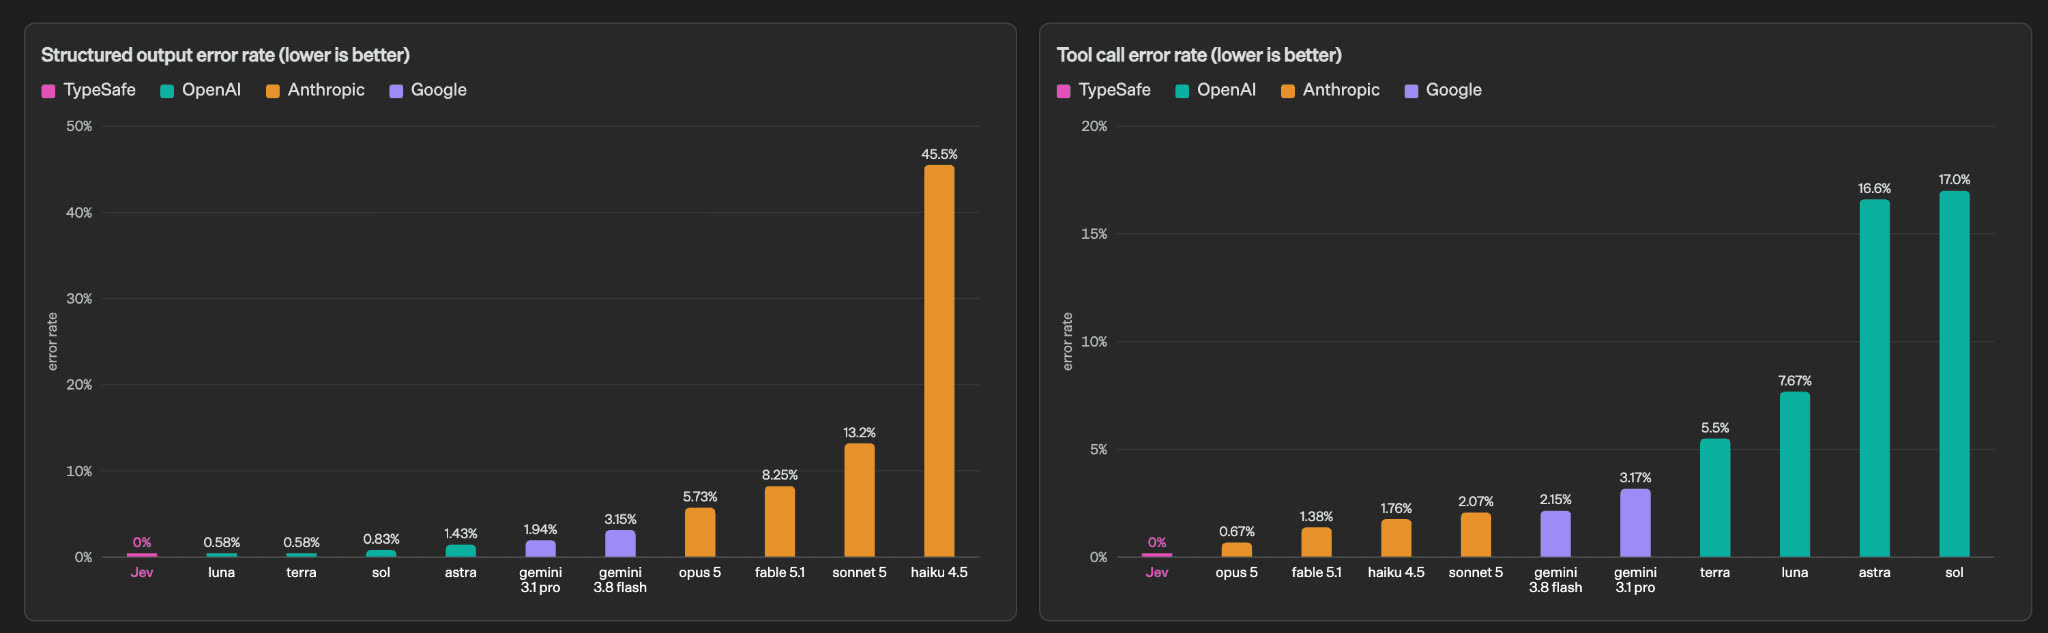
Именно здесь прячется тезис, который в анонсе звучит как техническая деталь, а по факту меняет цену вопроса. Агент с галлюцинацией — досадная мелочь: человек увидел, поправил, продолжил. Тот же сбой внутри цепочки из пяти шагов под гарантией по задержке — уже авария. TypeSafe приложили графики: доля ошибок структурированного вывода у Jev — 0% (гарантированно), у Anthropic haiku 4.5 — 45,5%, ошибки вызова инструментов у OpenAI sol — 17%. Цифры по LLM считали через OpenRouter, и компания сама оговаривает: смещение почти наверняка есть.
Где в этой бочке мёда дёготь
Бенчмарк «workflow evals» придумали сами: сравнение не с истиной, а со средним ответом двух сильнейших внешних моделей, а четыре workflow писали их же сотрудники — о смещении сказано прямо. Стоит и оговорка, что 193,6× по скорости и 444,6× по цене — верхняя граница реальной выгоды, а не медиана. Точных доказательств устойчивости цен нет: «мы не можем доказать, что это не демпинг». Открытых весов нет: доступ по списку раннего доступа. И самое практичное: Jev молчит. Ни объяснения, ни правки через просьбу — только выбранный вариант и уверенность. В канале «Start ИИ» автор адаптировал агентский бенчмарк BitGN: модель заняла 14-е место, часть задач оказалась за пределами возможностей, а собрать цикл или каскад посложнее не выйдет: потолок по числу вариантов — 255.
Спор «когда ИИ заменит людей» бесполезен, пока интеллект продаётся как рассуждение в секунду. Здесь его продают как решённую задачу в миллисекунду: не «порассуждай, что делать с алертом», а «закрой, поставь в очередь или действуй». Автоматизация всегда упиралась не в ум, а в предсказуемость. Модель, которая умеет только выбирать из списка и всегда называет свою уверенность, — первый кирпич в фундаменте систем, которым доверяют без человека рядом. Скучно, зато работает.